
文章目录
- 1. 论文信息
- 2. 论文创新点
- 3. 论文主要贡献
- 4. 研究方法
- 4.1 IF-Bench:红外图像理解基准
- 4.2 GenViP:生成式视觉提示
- 5. 实验验证
- 5.1 对比实验
- 5.2 模型规模与任务难度分析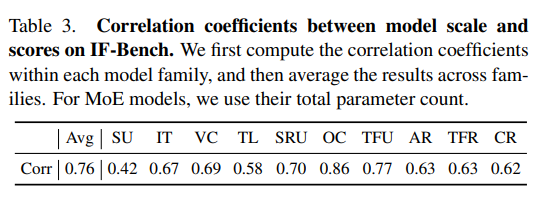
- 5.3 Thinking 模式对红外理解的影响
- 5.4 GenViP 的跨模型对比实验
- 5.5 编辑模型对 GenViP 的影响
- 5.6 消融实验
- 5.7 实验结论
- 6.个人声明
1. 论文信息
- 论文题目 IF-Bench: Benchmarking and Enhancing MLLMs for Infrared Images with Generative Visual Prompting
- 论文作者 Tao Zhang、Yuyang Hong 等
- 研究机构 中国科学院自动化研究所多模态人工智能系统实验室MAIS,
中国科学院大学人工智能学院,中国科学院自动化研究所航天信息研究中心 - 发表会议 CVPR 2026
- 代码链接 https://github.com/casiatao/IF-Bench
2. 论文创新点
- 针对红外图像理解建立专门基准。IF-Bench 不只测试场景分类或目标检测,而是覆盖粗粒度感知、细粒度感知和图像推理共 10 个维度。
- 通过评测设计控制偶然偏差。使用统一提示、选项循环置换、中英文双语测试和混合答案判定,增强结果可比性。
- 提出免微调的输入增强方法。GenViP 在推理时生成对齐 RGB 图,将其与原始红外图及红外文字先验一起输入,适用于不同 MLLM。
- 把编辑模型也纳入优化。从大量 RGB-T 候选对中筛选并均衡采样 50,000 对,对开源 Qwen-Edit-2509 微调,提高红外转 RGB 的质量。
3. 论文主要贡献
- 构建 IF-Bench:从 23 个红外数据集选出499 张图像、680 个高质量 VQA 问题,每题提供中英文版本。
- 系统评测40 多个开源和闭源 MLLM,分析模型规模、架构、MoE 和 Thinking 推理模式的影响。
- 提出训练免费的 GenViP,在多种模型上提升红外理解,最高相对提升约 7%。
- 构建 50,000 对 RGB-T 图像对微调 Qwen-Edit-2509,得到的 Qwen-Edit-2509-FT 在 IF-Bench 的 GenViP 设置中超过所比较的闭源编辑模型。
4. 研究方法
由两条主线组成:
- 构建一个能够可靠测量 MLLM 红外图像理解能力的基准
- 提出 GenViP,在不微调被测 MLLM 的前提下,通过推理阶段的输入改造提升红外理解效果
4.1 IF-Bench:红外图像理解基准
- 把红外理解拆成 3 类和10 个维度
- 粗粒度感知:场景理解(SU)、图像主题(IT)、拍摄视角(VC)。这类问题关注“这是什么环境、用于什么场景、从什么视角拍摄”。
- 细粒度感知:目标定位(TL)、空间关系理解(SRU)、目标计数(OC)、热特征理解(TFU)、动作识别(AR)。这类问题要求模型读取局部位置、数量、对象关系与热分布细节。
- 图像推理:热特征推理(TFR)和常识推理(CR)。前者要求根据亮暗或温差模式推断热源、温度变化原因;后者要求根据场景推断对象用途或可能行为。
- 数据构建流程
上图从左到右给出了 IF-Bench 的完整构建过程。
第一步:图像收集与筛选。作者从 InfPre 的 23 个红外子数据集中各随机采样 100 张图像,得到 2,300 张初始图像。之后先排除宽或高小于 200 像素的低质量图像,再进行人工视觉质量筛选,保留 1,166 张较清晰、可用于问答构建的红外图像
第二步:构建 VQA 初始集。对目标定位维度,作者先随机抽取 100 张图像进行人工标注:为可定位目标写简洁的文字描述,并给出精确边界框;剔除无目标图像后,得到 61 张有效人工标注图像。之后使用 Qwen2.5-VL-72B 自动生成单选题,每幅图最多生成 4 个问题,每题包含 4 个选项和正确答案。初始集合共得到 4,628 对 VQA。
第三步:两阶段人工校准。自动生成问题可能出现幻觉、歧义或答案与图像不匹配,因此作者进行粗粒度和细粒度两轮人工校准。筛除或修正的情形包括:逻辑不成立的问题;表达含糊的问题;仅凭图像无法可靠回答的问题;正确答案错误的问题;过于简单、重复、无法区分模型能力的问题。
最终得到的 IF-Bench 包含499 张红外图像和 680 个高质量 VQA。每个问题同时提供中英文版本,且选项 A–D 的正确答案位置尽量均衡。
- 评测协议:降低位置偏差、语言偏差和格式偏差
图片中右下部分给出四项评测设计
统一提示词:所有 MLLM 使用相同系统提示,要求只输出一个大写选项字母,尽量避免提示词不同造成的非模型能力差异。
循环评测:对同一道单选题循环置换四个选项及正确答案的位置。模型需要在全部排列下分别作答,再取平均分,从而减少“偏好选 A 或选 C”造成的偶然高分。
双语评测:每道题分别以中文和英文评测,最终分数取两种语言下的平均。与四种选项排列组合后,每题总共被评测 8 次。
混合答案判定:先用精确字符串匹配判断答案;当模型输出了额外解释或格式不规范时,再用 Qwen3-7B 解析出最终选项。这样可以避免把“答案正确但格式不规范”误判为错误。
4.2 GenViP:生成式视觉提示
在推理阶段改变输入,而不修改待评测 MLLM 的参数:先将红外图像翻译为语义和空间位置对齐的 RGB 图像,再将红外图、生成 RGB 图和文字先验共同输入 MLLM。
- 输入原始红外图像。原图保留温度分布、热源强弱和红外轮廓等特有信息。
- 图像编辑模型生成对齐 RGB 图。Image Editing Model 把红外图翻译为语义、空间布局尽量一致的自然 RGB 图,使输入外观更接近 MLLM 在预训练阶段熟悉的 RGB 分布。
- 加入文字先验(Textual Prior)。提示中补充红外图像的基本解释,例如亮暗区域与热响应相关,帮助模型在分析两张图时保留对热信息的关注。
- 双图与提示共同输入 MLLM。MLLM 同时看到原红外图和生成 RGB 图,并根据修改后的评测提示进行回答。
GenViP 的效果依赖“红外转 RGB”是否保持语义与空间对齐。没有直接使用原始开源编辑器,而是为 Qwen-Edit-2509 构建了专用的 RGB-T 微调集
数据处理过程如下:
- 收集超过 370,000 对 RGB-T 候选图像;
- 人工剔除红外图和 RGB 图空间错位的来源;
- 剔除任一边小于 200 像素的图像对;
- 过滤亮度过低图像,并计算红外图和 RGB 图的 Canny 边缘 Dice 系数,删除结构对齐度过低的样本;
- 使用 Qwen2.5-VL-32B 对余下图像对进行质量评估;
- 用 DINOv3 抽取视觉特征并去重,同时移除红外特征与 IF-Bench 测试图像过于接近的样本,防止评测数据泄漏;
- 对 RGB DINOv3 特征做层次聚类和均衡采样,避免训练集过度集中于少数场景。
从 156,330 对高质量样本中得到 50,000 对 RGB-T 图像对,用于微调 Qwen-Edit-2509,得到 Qwen-Edit-2509-FT。这里微调的是图像编辑器,而不是参与理解评测的 MLLM;因此 GenViP 对不同 MLLM 仍保持免微调、可迁移的特点。
5. 实验验证
5.1 对比实验
第一,模型规模总体有帮助,但小模型间的架构差异更大。例如,LLaVA-OneVision-1.5-4B-Instruct 的平均分为 75.2,而 Qwen2.5-VL-3B 为 66.0,规模接近但相差 9.2 分。8B 级别中,Qwen3-VL-8B-Instruct 为 78.8,而 InternVL3.5-8B 为 69.1,相差接近 10 分。说明在中小规模阶段,视觉编码器、训练数据、跨模态对齐方式与推理策略会显著影响红外性能。
第二,Qwen3-VL 的中小模型具有较强性价比。Qwen3-VL-8B-Instruct 的总分为 78.8,高于 Qwen2.5-VL-72B 的 78.1,并接近 InternVL3-78B 的 80.2。这表明红外理解并不只依赖总参数量,模型架构和视觉语言训练方式同样关键。
第三,MoE 提供了较好的精度与推理效率折中。InternVL3.5-30B-A3B 的平均分为 74.4,高于稠密 InternVL3.5-14B 的 73.6;但 MoE 每次推理仅激活部分专家参数。这里的比较说明,在相近或更低的实际激活计算量下,MoE 可以取得更高分数。
第四,开源与闭源模型差距有限。闭源 Doubao-Seed-Vision-1.6-250815 的最高平均分为 84.2;开源 InternVL3.5-241B-A28B 的平均分为 83.9,两者相差 0.3 分。表中 Gemini-2.5-Pro 为 82.0,也低于部分开源大模型。论文据此认为,红外图像理解并非只有闭源模型具备实用价值。
5.2 模型规模与任务难度分析![]()
Table 3 统计不同模型系列中“参数规模”和“各维度得分”的 Pearson 相关系数,再在系列间取平均
其中,热特征理解(TFU)的相关系数最高,为0.86;目标计数(OC)为0.70;空间关系理解(SRU)为0.70。这些任务更依赖局部细节、对象间关系或热分布判别,因此对模型容量更敏感。相比之下,场景理解(SU)的相关系数为 0.42,说明“识别大致场景”较容易,小模型也能达到相对可用的水平
Figure 6 用箱线图展示了不同模型在各维度上的分数分布。粗粒度任务中的场景理解与图像主题得分集中在较高区间;热特征推理和常识推理也整体较高。相比之下,目标定位、空间关系、目标计数、热特征理解和动作识别的中位数更低、方差更大。
目标计数和空间关系理解平均分低于 60,表现较好的模型也仅在 70 分左右
5.3 Thinking 模式对红外理解的影响
这组实验说明,Thinking 更适合需要综合热模式、解释温度变化原因的推理任务;它却未必帮助依赖精确视觉观察的任务,尤其是目标定位
5.4 GenViP 的跨模型对比实验
所有被测模型使用 GenViP 后总分均有提升
最显著的提升出现在 Qwen2.5-VL-3B(+4.8)和 InternVL3.5-1B(+4.2)上。随着模型规模增大,提升趋于减小:大型模型本身对输入分布偏移更稳健,且基线分数已较高,可改进空间更小。值得注意的是,Qwen3-VL-8B-Instruct 加入 GenViP 后达到 80.3,接近 InternVL3-78B 的 80.2,说明输入域对齐可以在一定程度上缩小模型规模差距。
5.5 编辑模型对 GenViP 的影响
只替换红外转 RGB 的图像编辑器。未使用 GenViP 的 Qwen2.5-VL-7B 基线分数为 71.1。使用不同编辑模型后:
所有编辑模型均可提升红外理解,说明“生成 RGB 视觉提示”的方向有效;但转换质量会直接影响最终理解性能。未经微调的开源 Qwen-Edit-2509 为 72.7,低于两个闭源编辑器;使用筛选后的 50,000 对 RGB-T 数据微调后,Qwen-Edit-2509-FT 达到 74.2,超过表中的闭源编辑器。这验证了高质量、空间对齐的红外转 RGB 结果是 GenViP 成功的关键条件
5.6 消融实验
- 原始红外图不可替代。单独输入 RGB 翻译图的平均分只有 69.2,低于红外基线 71.1;生成图不能完整保留热分布信息。
- RGB 翻译图确实提供补充。将原图与 RGB 图一起输入后,平均分从 71.1 提升到 73.2,说明 RGB 外观有助于对象识别、空间关系、计数和动作等任务。
- 文字先验主要帮助热相关任务。仅加文字先验时整体提升有限,但热特征理解和热特征推理改善明显;在双图输入基础上加入先验后,达到最高 74.2 分。
5.7 实验结论
IF-Bench 的主对比实验表明,现有 MLLM 已能较好完成粗粒度场景理解和部分推理,但在目标定位、空间关系、计数和热特征细节上仍不稳定。模型规模通常有帮助,MoE 架构具有较好的效率折中,Thinking 则呈现任务依赖性,不能保证整体提升。
GenViP 的跨模型比较、编辑器控制实验和输入消融共同说明:红外理解中的一个关键问题是 RGB 训练分布与红外输入之间的差异。通过“原始红外图 + 对齐 RGB 图 + 热信息文字先验”的组合,模型可以同时获得热物理线索和更熟悉的 RGB 语义线索;其中原始红外图负责保留热信息,RGB 图负责降低域偏移,文字先验负责强化热相关推理。
6.个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。

:从 Java 后端转 Agent,第一座脚手架叫 LangChain)


